 Windows
 macOS
 Android
 iOS
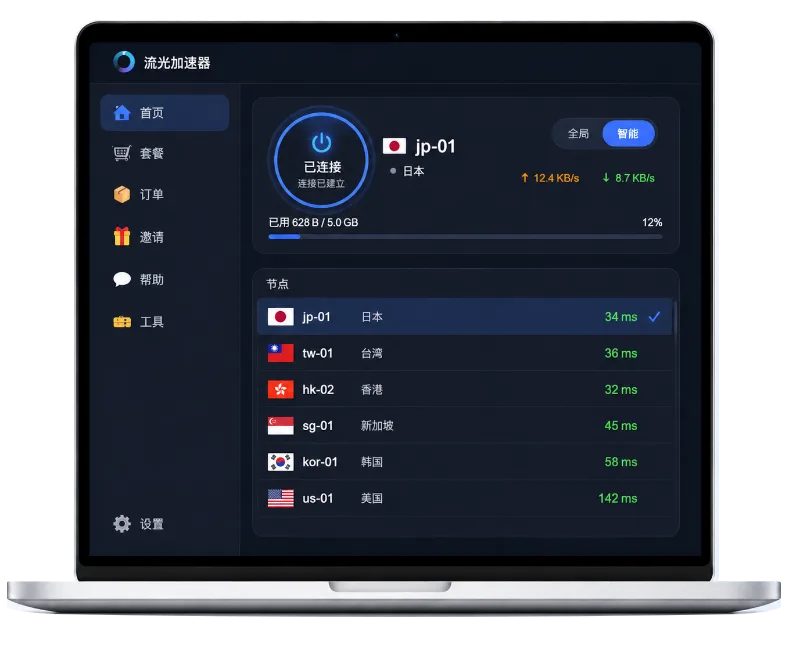
节点可用性监控的重点,不是单纯记录某个地址能否返回结果,而是判断节点能否在预期时间内持续完成目标任务。一个节点偶尔成功,并不等于长期可用;反复短暂中断,也可能比一次较长故障更难发现。
新手不必先搭建复杂的监控体系。按照“定义标准、布置探针、建立告警”三步推进,通常就能形成可运行的基础方案。
第一步:先把“可用”写成可判断的标准
如果没有明确标准,节点可用性监控最后只能得到一串难以解释的日志。应先回答三个问题:检查什么、多久算超时、连续失败几次才算故障。
区分节点存活与业务可用
节点存活只能说明设备仍能响应探测,不能证明服务正常。例如云主机仍处于运行状态,但磁盘已满、进程停止或关键端口未监听,用户依然无法使用。基础检查可观察地址是否响应,业务检查则应验证指定服务是否能完成一次完整操作。
建议至少设置两层结果:第一层是“可达”,第二层是“可用”。前者适合发现网络中断,后者适合判断应用、代理或接口是否真正工作。两层结果分开记录,能减少误报。
确定超时和失败规则
在普通公网环境中,单次探测超时可先设为约3至5秒;探测间隔可从30秒或60秒开始。移动网络、跨地区链路和低配置设备的波动通常更大,不能直接套用同一阈值。
一个实用起点是连续3次失败后告警,连续2至3次成功后恢复。若节点承载支付、远程控制等重要任务,应缩短发现时间;若只是低频同步,则可适当放宽,避免把短暂抖动当成事故。
第二步:用不同位置的探针验证节点
单个地点监测容易把本地网络故障误判为节点故障。节点可用性监控至少应配置两个相互独立的观测位置,例如办公室网络与云平台探针,或家庭宽带与手机热点。两处同时失败,故障判断更可信;只有一处失败,则应先排查探针自身。
选择工具与部署方式
小规模场景可以使用 Uptime Kuma,通过网页界面添加目标、设置间隔并接收通知。已有指标体系的团队,可采用 Prometheus 配合 blackbox_exporter,将探测结果写入统一的时序数据库,再由 Grafana展示趋势。前者上手快、维护简单,后者便于长期分析和统一告警,但配置成本更高。
探针不宜全部放在同一供应商或同一机房。以一个部署在阿里云新加坡地域的节点为例,可以增加另一家云平台或不同运营商网络中的探针。地域差异越大,越能识别本地出口、区域路由和机房侧问题,但跨境链路也可能带来更高波动,需要单独设置判断标准。
记录足够的上下文
每次探测至少保存时间、探针位置、目标标识、检查类型、结果、耗时和失败原因。记录这些信息后,才能区分“节点未响应”“服务返回异常”和“某个探针自身失联”。不建议只保存一个百分比,因为单一可用率无法解释故障发生在哪个环节。
第三步:建立分级告警和复核流程
节点可用性监控真正产生价值,取决于告警是否能帮助人快速行动。所有异常都立即发送高优先级通知,容易造成告警疲劳;完全不告警,又会错过短时但频繁的故障。
- 先设置提醒级别:单次失败只记录;连续两次失败发送低级提醒;达到连续三次失败再触发主要告警。
- 再设置恢复条件:不要一次成功就宣布恢复,可要求连续2至3次成功,并观察后续几分钟是否再次失败。
- 按影响区分通知:只有一个探针失败时通知维护人员复核;多个独立探针同时失败时,升级到电话、短信或值班系统。
- 保留故障证据:告警中带上节点标识、探针位置、最近失败时间、连续失败次数和最近一次成功时间,减少人工查找。
| 现象 | 较可能的解释 | 处理建议 |
|---|---|---|
| 单个探针失败 | 探针网络或本地出口异常 | 用第二位置复核,暂不判定节点故障 |
| 多个探针同时失败 | 节点、服务或区域链路异常 | 检查服务进程、资源状态和变更记录 |
| 探测成功但业务失败 | 节点存活,目标服务异常 | 查看应用日志、依赖服务和返回内容 |
| 失败与恢复反复出现 | 链路抖动、资源不足或服务重启 | 拉长时间窗口,统计丢包率与失败时段 |
上线后的校准方法
初始阈值只是起点。运行一周后,按工作日、夜间、地区和探针分别查看结果。如果某个探针频繁单独报警,而其他探针稳定,应先检查探针线路;如果所有探针都在固定时段失败,应结合节点日志和计划任务分析。
不要只看平均可用率。某节点一个月总体达到99.9%,仍可能在业务高峰期连续中断。应同时关注最长连续故障、每次故障持续时间、失败次数和恢复耗时。对实时交互服务,短暂但重复的异常往往比低频长故障更值得优先处理。
常见问题
节点可用性监控一定要使用多台探针吗?
不一定。个人或测试环境可先使用一台,但生产环境建议至少两个独立位置,否则很难排除本地网络故障。
探测间隔越短越好吗?
不是。间隔越短,发现更快,但会增加探针请求、日志量和误报机会。30至60秒通常适合起步,重要服务再根据实际故障代价调整。
为什么节点能响应却仍然不可用?
因为设备响应不代表应用正常。应增加业务层检查,例如验证指定服务是否监听、返回内容是否符合预期,或能否完成一次关键操作。
多久应该重新调整规则?
上线后一周进行首次复核,之后可按月或在网络、服务架构发生变化后调整。阈值应依据历史结果和业务影响确定,而不是照搬其他节点。
做好这三步后,节点可用性监控就具备了明确标准、独立证据和可执行的处置路径。先保证判断可信,再逐步增加指标和自动化动作,通常比一开始追求复杂平台更稳妥。